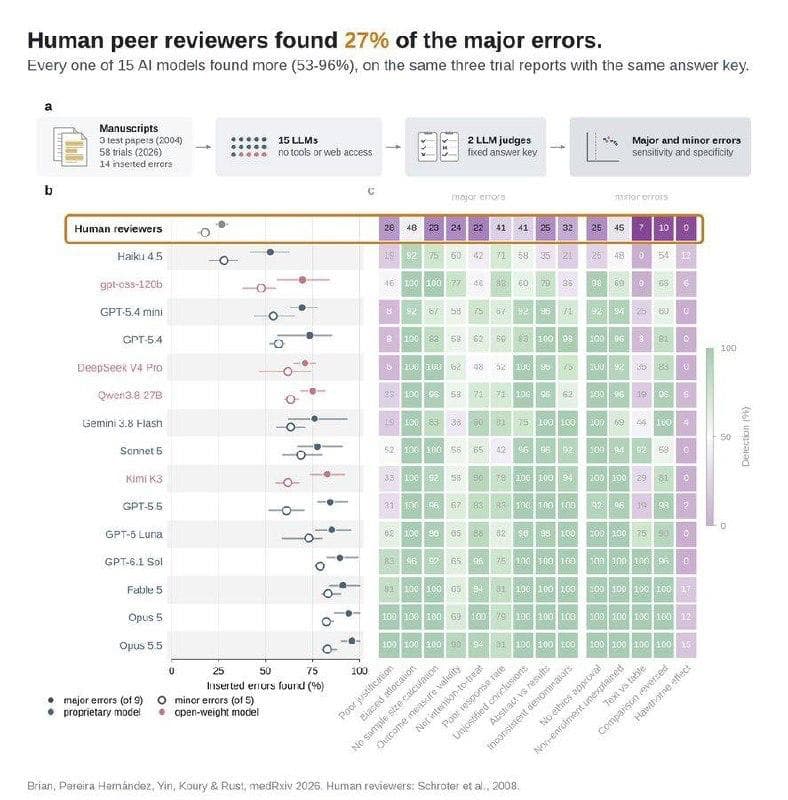
Рецензенты-люди нашли 27% крупных ошибок в статьях, даже самая глупая модель нашла в два раза больше.
На картинке главный график новой работы, авторы в основном из ResearchHub Foundation. Взяли три рукописи о клинических испытаниях с теми же 14 ошибками, на которых в исследовании Шротер и соавторов 2008 года проверяли рецензентов-людей: 9 крупных, например нет расчёта размера выборки или выводы не следуют из данных, и 5 мелких. Люди из контрольной группы, без специального обучения, нашли 27% крупных ошибок, а рецензия занимала от 5 до 8,5 часов.
Теперь рукописи отдали 15 моделям, без поиска и интернета, со стандартной инструкцией рецензента медицинского журнала: отрецензировать, как любую рукопись. О вставленных ошибках не предупреждали. Каждая модель нашла больше людей: от 53% крупных ошибок у Haiku 4.5 до 96% у Opus 5.5. Открытые модели, Qwen3.8 27B, DeepSeek V4 Pro, Kimi K3 и gpt-oss-120b, тоже.
Отсутствие расчёта размера выборки люди отметили в 23% случаев, модели — от 67 до 100%. А слабое обоснование самого исследования шесть моделей из 15 замечали реже людей.
Отсюда вывод: ИИ прекрасно применять для рецензирования. У нас клиенты пошли, например, давать ИИ проверять выводы врачей и юристов. Не писать за людей, в проверять то, что написали люди.
Как первый шаг принятия – ок. Потом всё равно и писать будет ИИ.
github.com/rustlab1/llm-peer-review-benchmark
t.me/zvasilchannel/2557