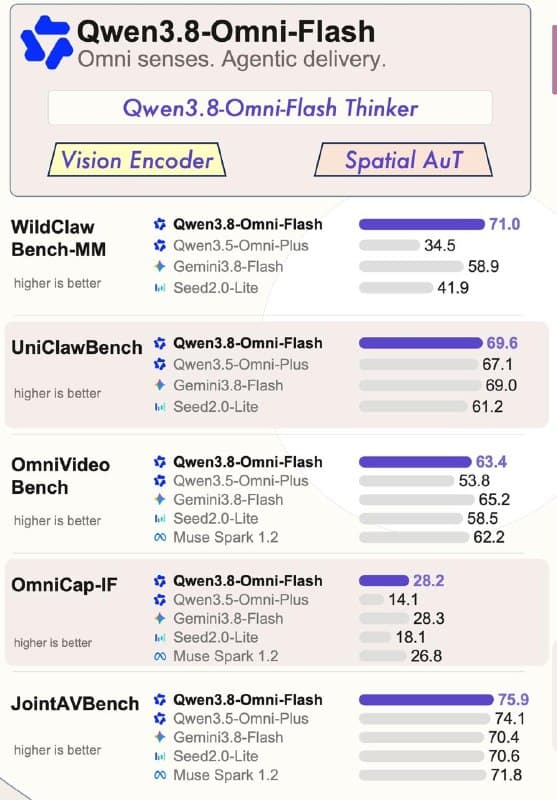
Омнимодальность на примере Qwen3.8-Omni-Flash
Работа с голосом у многих моделей реализуется цепочкой из трёх моделей: распознавание переводит речь в текст, языковая модель отвечает текстом, синтезатор его озвучивает. Этот подход довольно долгий по задержкам.
Омнимодальная модель устроена иначе. Энкодеры режут картинку и звук на токены, и дальше один трансформер обрабатывает их вместе с текстом. Поэтому она может связать интонацию в голосе с тем, что происходит на видео.
Свежий пример — Qwen3.8-Omni-Flash, вышла в сентябре. На входе текст, картинки, звук и даже видео (!).
— встречу до часа разбирает целиком: кто говорил, что сказал, какие задачи и риски;
— на длинном видео может сама решать, что смотреть и слушать: в таком режиме на OmniVideoBench точность 67,8 вместо 63,4, а токенов уходит почти вдвое меньше;
— час аудио на входе стоит меньше цента
— версия Realtime отвечает голосом: на шестисекундную фразу первый звук примерно через секунду.
Но всё это только по API. Открытая Qwen3.8-Flash-Next понимает только текст и картинки.
Свежих открытых и хороших omni моделей сильно не хватает. Хотим.