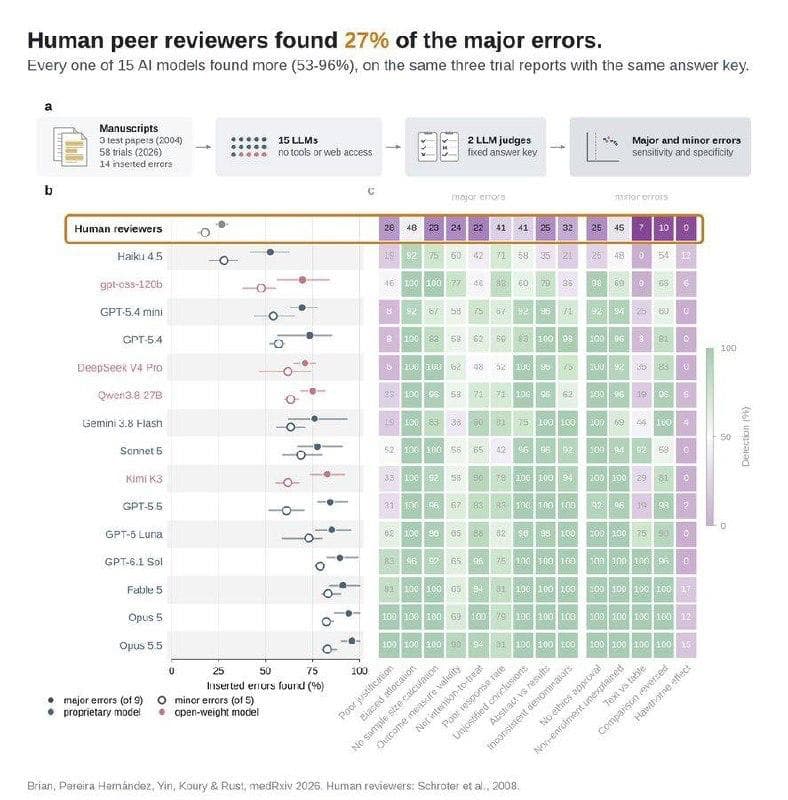
ИИ для рецензирования научных статей
Сравнение моделей и людей при поиске ошибок в рукописях клинических исследований и практический вывод о проверке работы специалистов.
Материалов по теме: 85
Сравнение моделей и людей при поиске ошибок в рукописях клинических исследований и практический вывод о проверке работы специалистов.
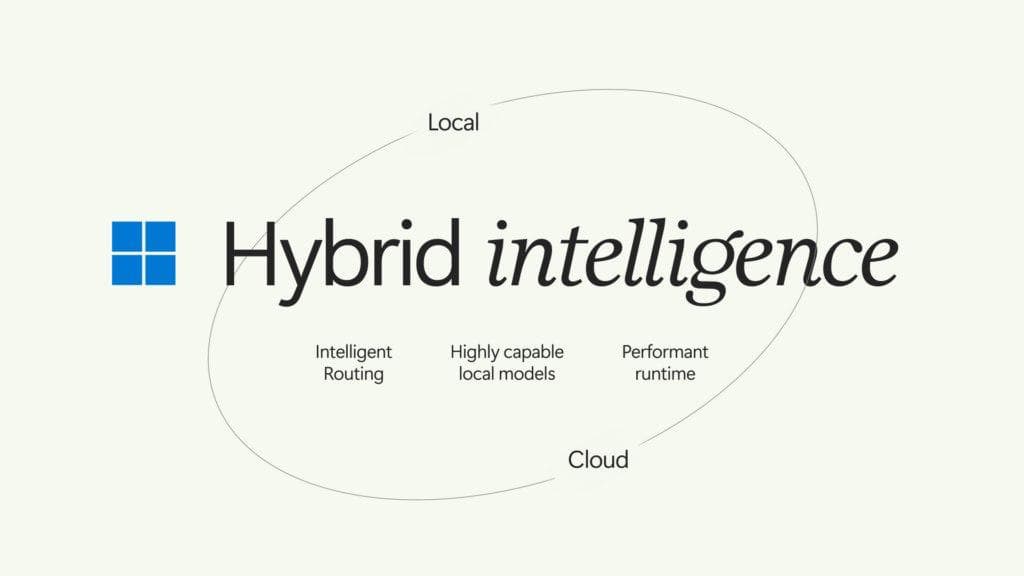
Microsoft связывает Windows, локальные модели и железо Nvidia в стратегии для корпоративных клиентов, которым важны контроль расходов и конфиденциальность.
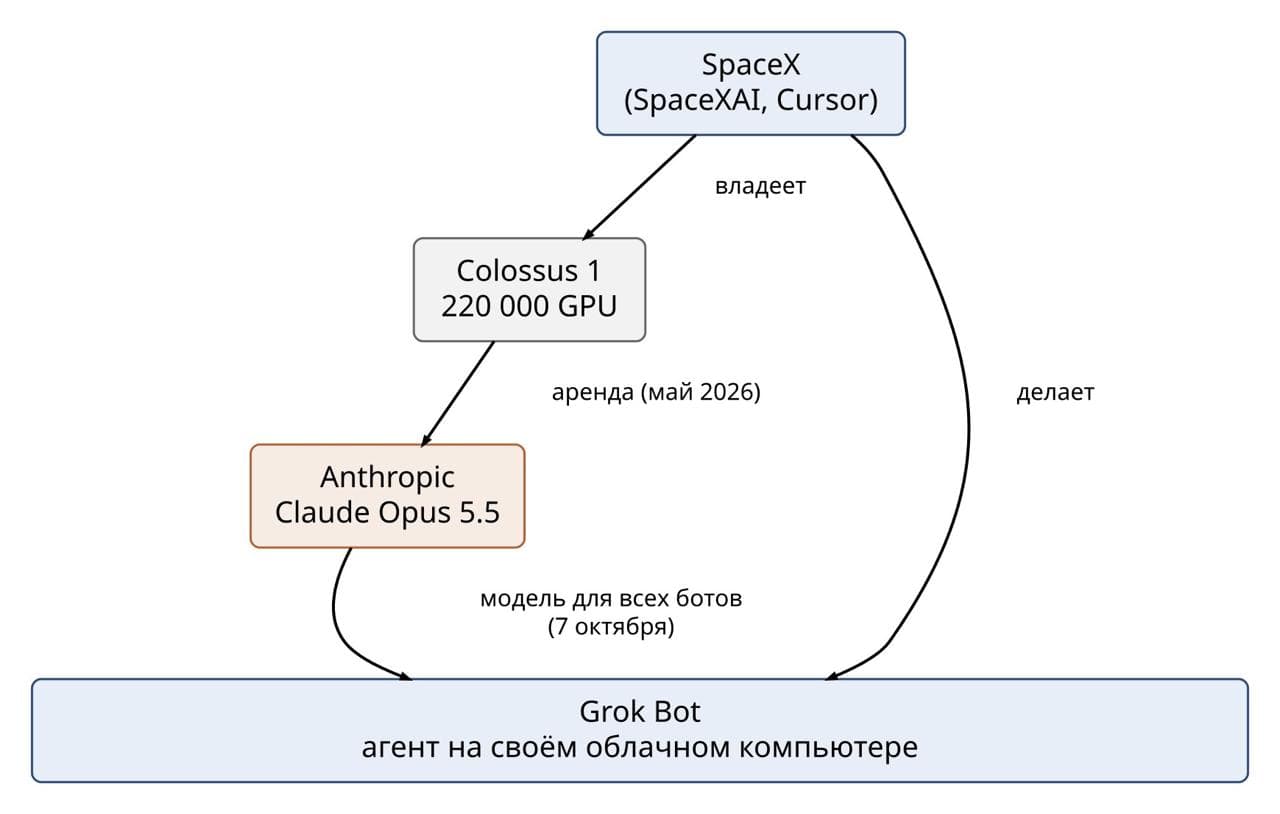
SpaceX будет выбирать лучшую модель под каждую задачу; автор сравнивает Grok с Opus и объясняет, почему трудно удерживать фронтирный уровень.
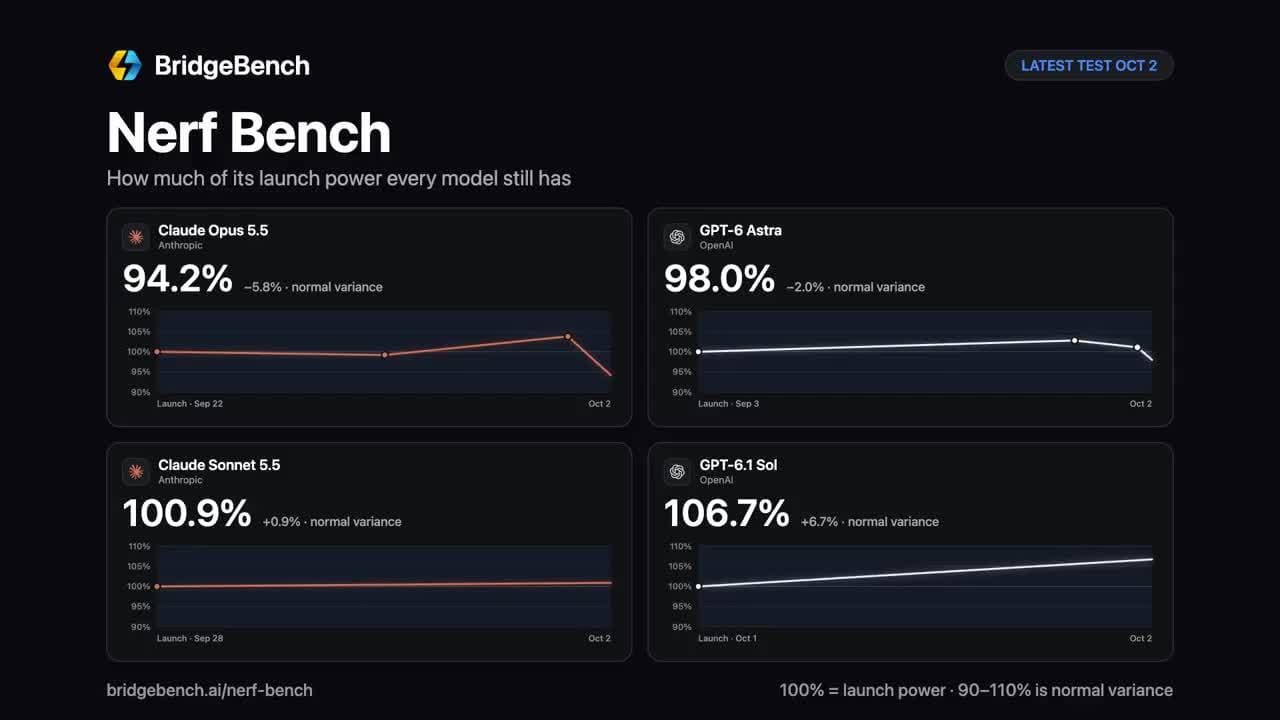
Бенчмарк BridgeMind отслеживает качество моделей после релиза, но не измеряет работу агентов с инструментами и репозиториями.
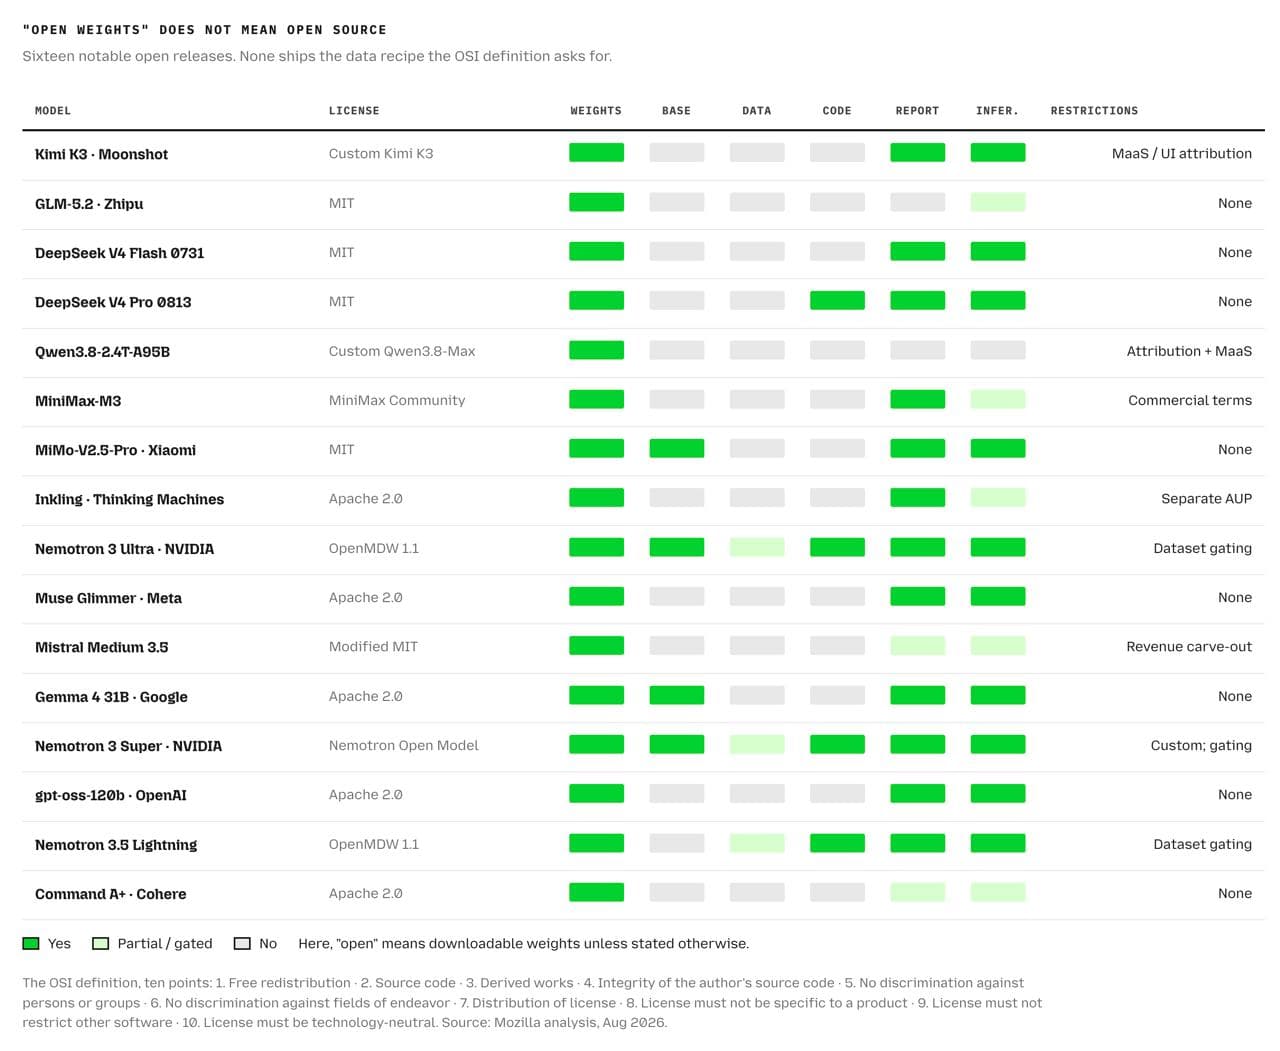
Автор сравнивает вклад компаний в открытые модели и отмечает, что у них остаются закрытые данные и ноу-хау.
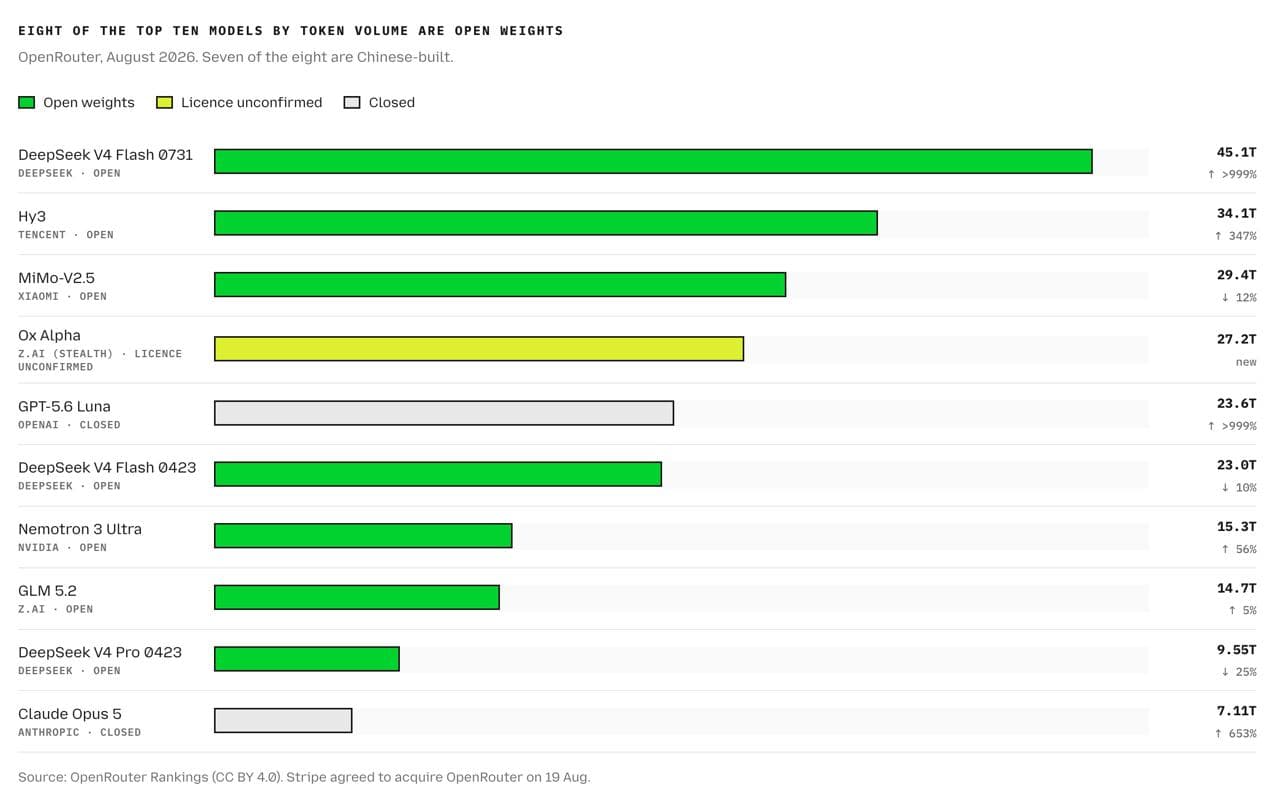
Автор разбирает популярность открытых моделей на OpenRouter и возможную роль цены, инвестиций в исследования и задержек.
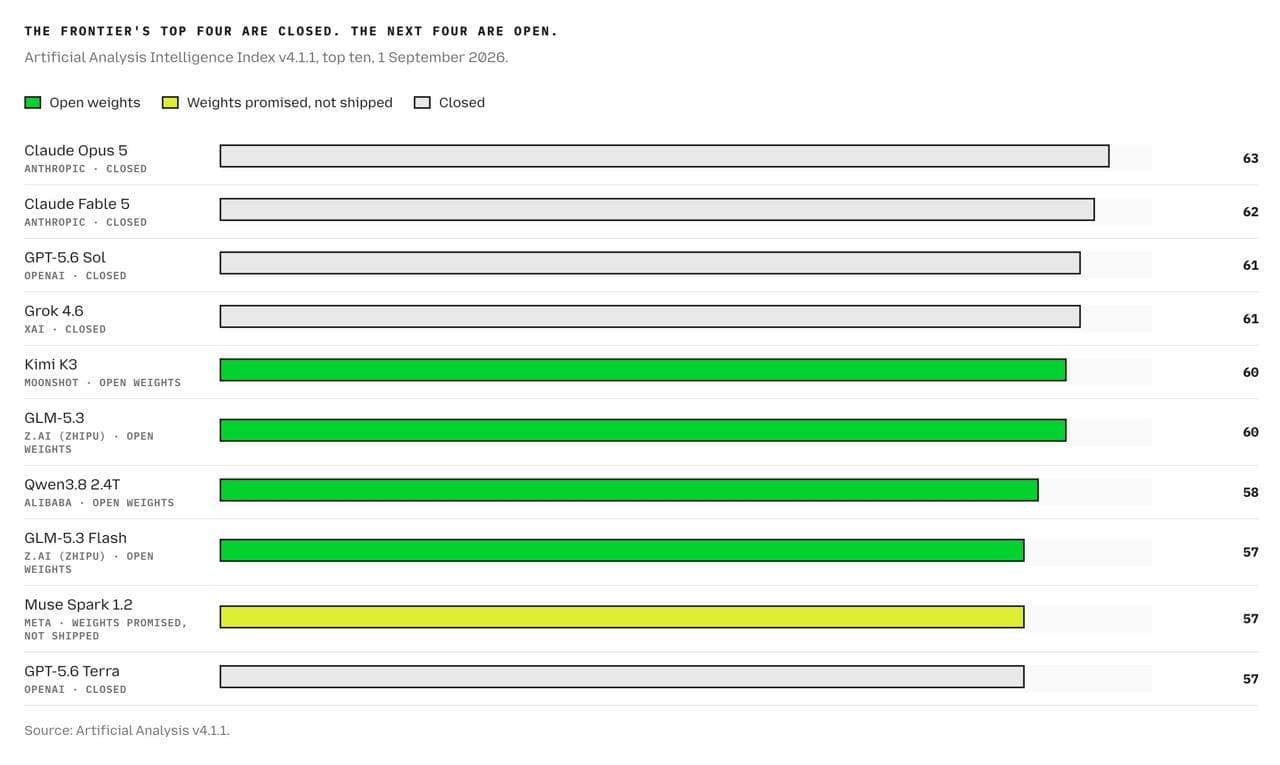
Отчёт Mozilla показывает, что лучшая открытая модель отстаёт от лучшей закрытой всего на 3 пункта индекса способностей.
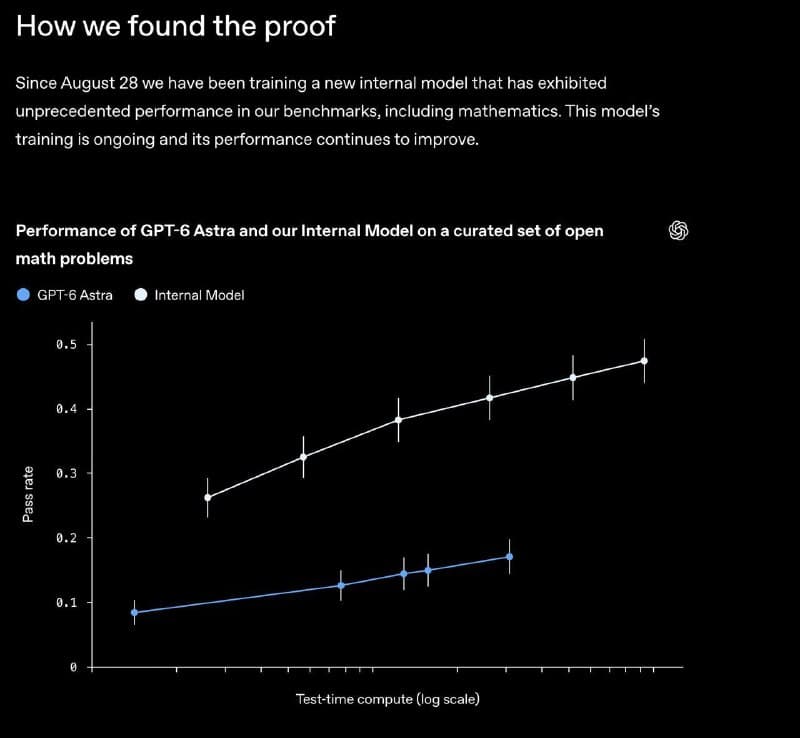
Конкуренция между разработчиками сокращает ориентировочный разрыв между поколениями ИИ-моделей до нескольких месяцев.
Разбираем, как низкая точность вычислений удешевляет инференс и почему ощущение вечерней деградации моделей пока остаётся гипотезой.
Проблемы DeepSeek с обучением модели на Huawei Ascend показывают риск незрелой инфраструктуры; у Google TPU может быть похожая цена.

Grok 4.6 сочетает качество фронтирных моделей, высокую скорость и низкую цену, поэтому подходит как быстрый ревьюер в Cursor CLI.

Бесплатный ChatGPT на Luna обещает безлимитные текстовые чаты, показывая, как дешёвые модели меняют экономику базовых тарифов.

Что Anthropic рассказала о блокировке Fable 5, проверке гражданства и новых ограничениях доступа.
Почему возможность запускать большой вариант будущей GPT-модели на чипах Cerebras может стать важным сдвигом.
Что значит высокий результат GLM-5.2 в Code Arena и почему китайские Fable-like модели могут быстро прийти в open source.

Практическое наблюдение: QWEN с серверов Alibaba может часто отказывать из-за цензуры, хотя остаётся сильной open-source моделью для локального размещения.

Как Anthropic может превратить историю с ограничениями вокруг Fable и Mythos в стратегический маркетинговый актив.
Что происходит, когда модель успевают оценить для сложных задач, а доступ к ней резко ограничивают для пользователей вне США.
Почему в промптах лучше писать позитивную инструкцию вместо запрета и что делать с системными промптами.

Как факт-бенчмарк даёт нижнюю оценку параметров закрытых LLM и почему эрудиция хуже сжимается дистилляцией.

Почему на личных сложных задачах экономия на фронтирных моделях часто обходится дороже, чем подписки и токены.

Anthropic описал три бага Claude Code, из-за которых пользователи действительно могли видеть ухудшение качества работы модели.

Почему блокировки и KYC в AI-инструментах делают диверсификацию стека практическим навыком.
Практические наблюдения о новой версии Opus: скорость, vision, самостоятельность и цена использования.

Почему в экономике ИИ одновременно выигрывают гиперскейл-модели и сверхкомпактные модели, а середина пустеет.

Сравнение скорости, стоимости и качества Sonnet 4.6 и Opus 4.6 для повседневной работы в Claude Code.

Как OpenAI снижает риск вредных ответов на стресс, тревогу и кризисные сигналы пользователей.

Почему письмо OpenAI о дистилляции DeepSeek может стать подготовкой к новым ограничениям на ИИ-модели.

Model Council отправляет один запрос в несколько моделей, синтезирует ответ и показывает зоны согласия и расхождения.

Данные Epoch.AI показывают, что запуск моделей может быть прибыльным, а убытки AI-компаний в основном связаны с R&D и гонкой новых моделей.

Поиск и все материалы раздела — в общей ленте.
КОНТАКТЫ
Напишите через форму на сайте или напрямую в Telegram. Быстро поймём, где ИИ может дать эффект, какой формат подойдёт руководителю или команде и с чего начать.
Менторская консультация
60 000 ₽