NerfBench: бенчмарк, который проверяет, не «понерфили» ли модель
Стал ли Opus 5.5 тупее после релиза?
Я писал, что жалобы типа «ChatGPT отупел» — миф: проходит восторг неофита, и начинаешь замечать проблемы. Но жалобы типа «модель понерфили» никуда не делись, поэтому в BridgeMind сделали бенчмарк, который контролирует качество модели после релиза.
Как устроено:
— когда модель начинают отслеживать, её первый прогон замораживают как 100%;
— дальше те же 50 задач гоняют минимум три раза в неделю, а когда про модель активно пишут, что её понерфили, чаще. Задачи — починка багов, разбор и написание кода, алгоритмы, SQL, безопасность. Каждую по три раза, 150 попыток. Код запускают на тестах, ответы сверяют точно, другая модель ничего не оценивает;
— Если модель решает так же, но тратит больше токенов или денег, мощность падает. Изменение цены тоже видно;
— разброс 90–110% считается шумом. Выход за коридор публикуют, только если он держится два прогона подряд.
Меряют модель такой, какой её отдают пользователю: роутинг, системные инструкции, настройки рассуждений и лимиты ответа тоже считаются. Так что падение не обязательно значит, что подменили веса.
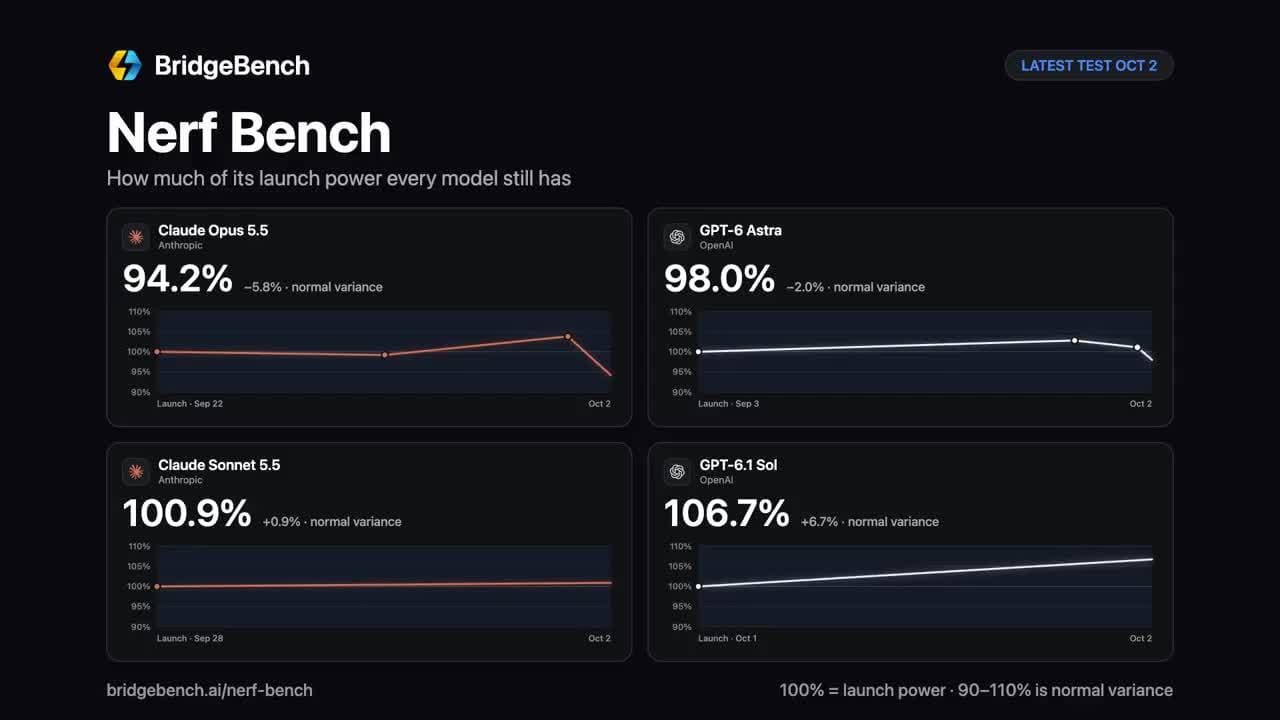
На картинке доска на 2 октября. Opus 5.5 за день упал со 103,8% до 94,2%, и BridgeMind в тот же день написали, что это пока обычный разброс и говорить о нерфе рано. 4 октября — 96,5%. Проценты считают от собственного старта каждой модели, поэтому сравнивать модели по доске нельзя: 106,7% у GPT-6.1 Sol не значит, что она сильнее Opus 5.5.
Чего бенчмарк не покажет?
Каждая задача — один ответ без инструментов и репозитория: это проверка самой модели, а харнеса — не агентной работы с файлами. А ежедневные обновления мы видим именно в качестве харнеса, поэтому ИМХО — бенчмарк устарел.
Задания и ответы закрыты, чтобы на них не обучали модели, поэтому перепроверить снаружи нельзя; остальная методика опубликована. Отслеживают пока всего четыре модели. Осталось больше — дорого)
bridgebench.ai/nerf-bench
bridgebench.ai/blog/the-methodology-of-nerfbench