ИИ для рецензирования научных статей
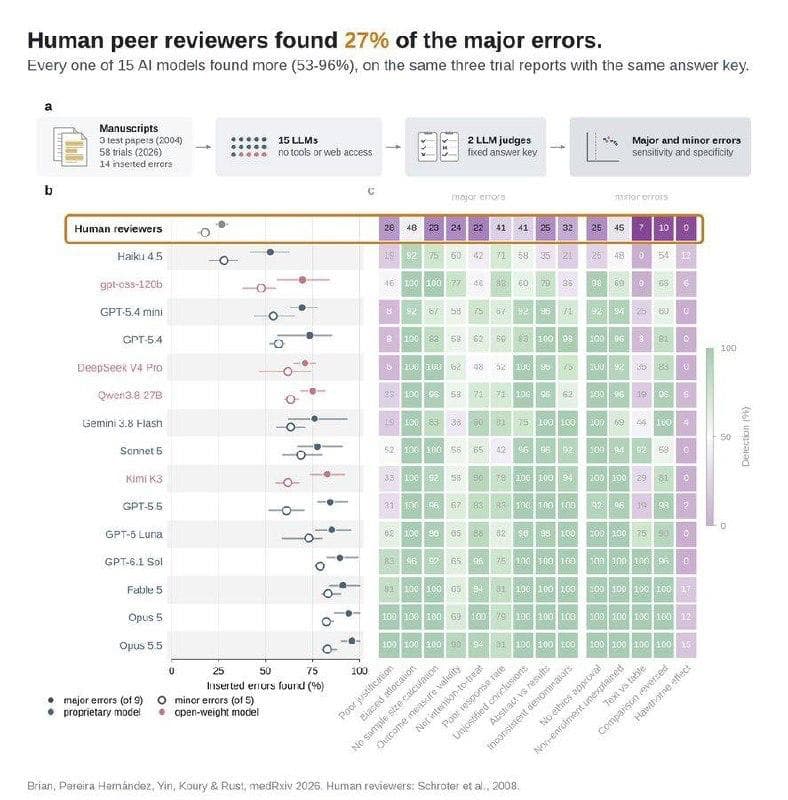
Сравнение моделей и людей при поиске ошибок в рукописях клинических исследований и практический вывод о проверке работы специалистов.
Материалов по теме: 32
Сравнение моделей и людей при поиске ошибок в рукописях клинических исследований и практический вывод о проверке работы специалистов.
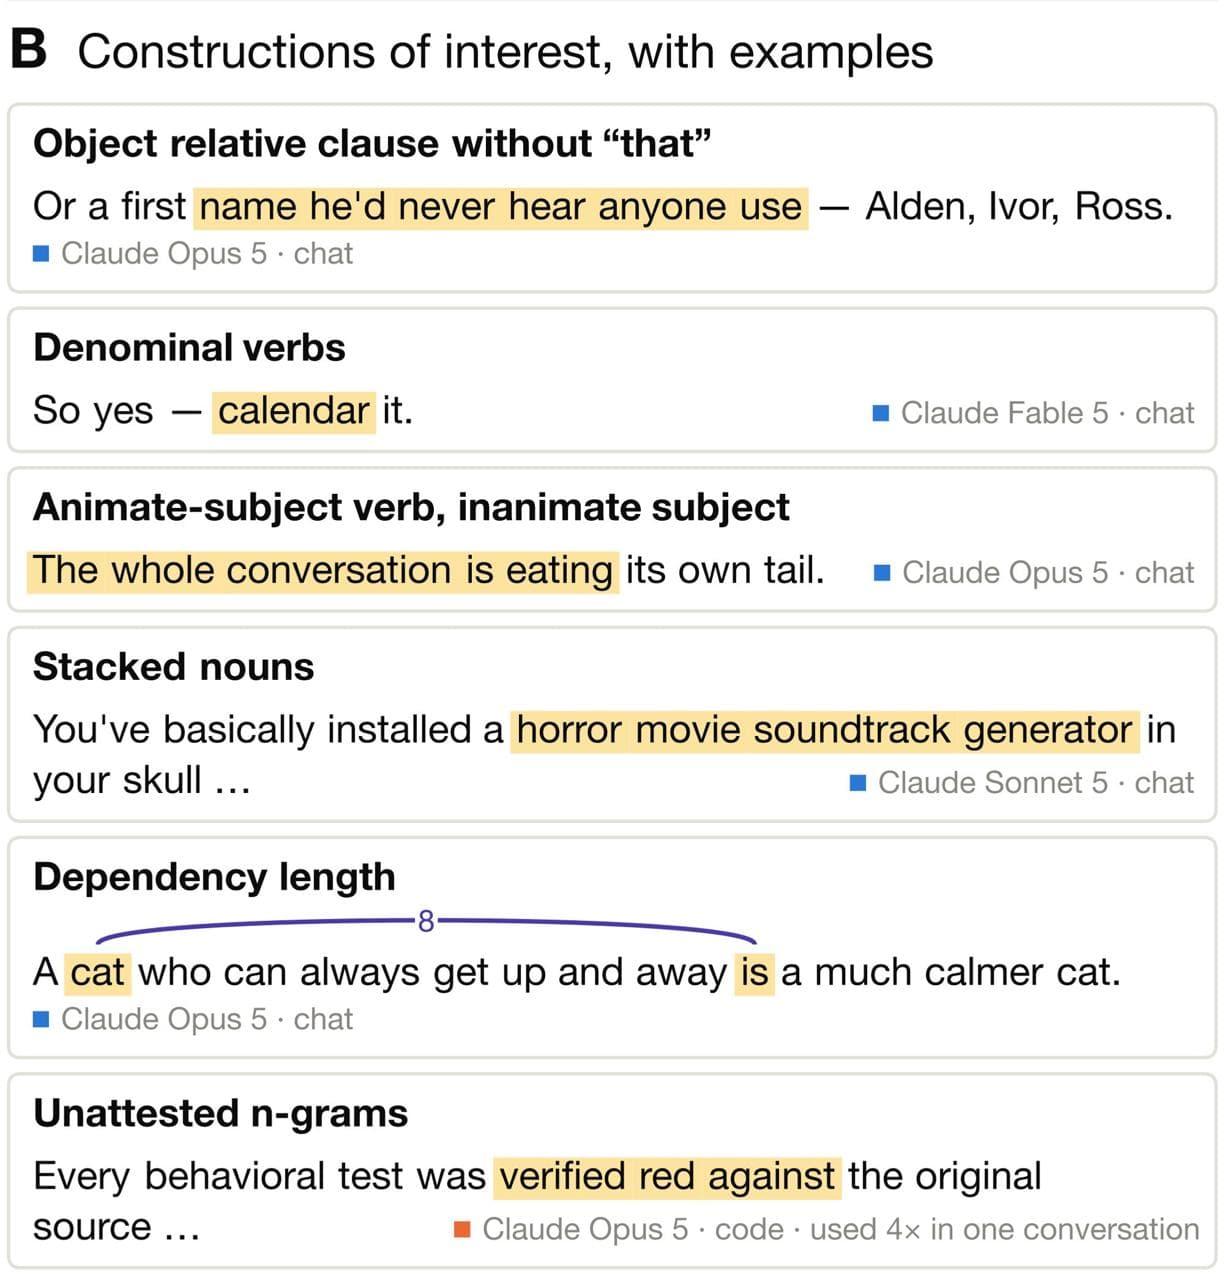
Исследование шести языковых конструкций, на которых читатели спотыкаются в текстах моделей, и гипотеза о причинах.
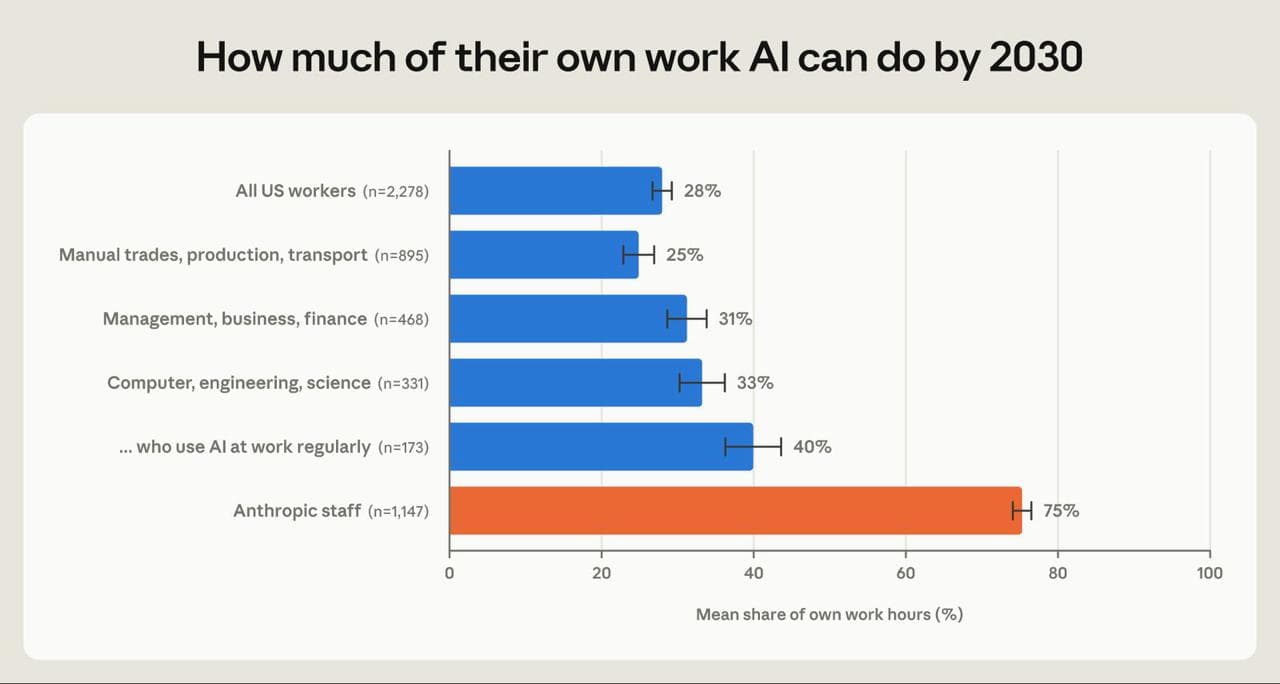
В опросе Anthropic американцы оценили долю своей работы, которую сможет выполнять ИИ к 2030 году, в 28%, сотрудники компании — в 75%.
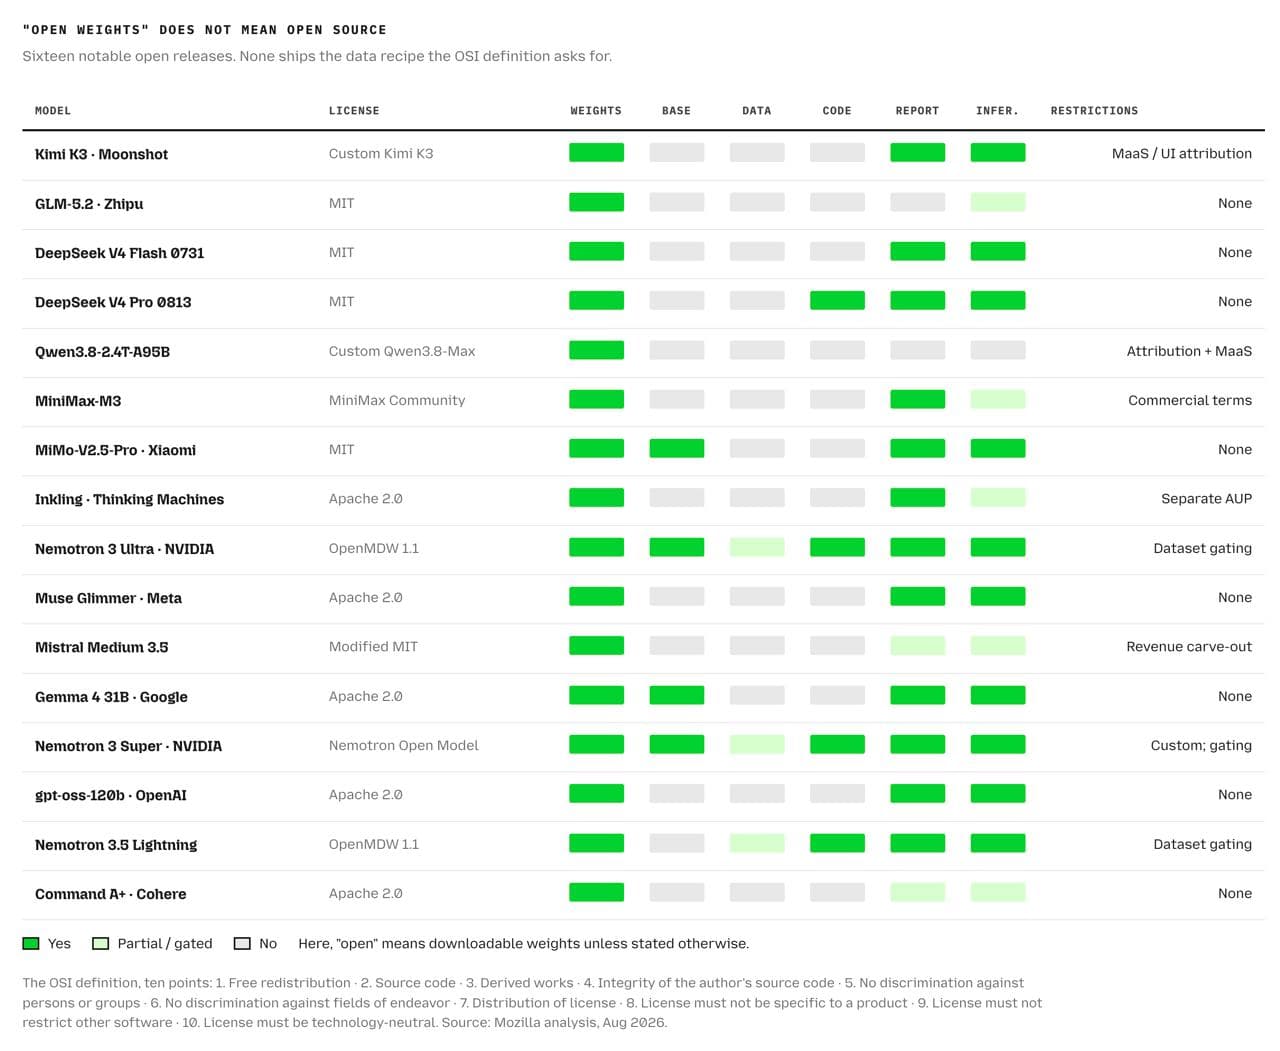
Автор сравнивает вклад компаний в открытые модели и отмечает, что у них остаются закрытые данные и ноу-хау.
Автор разбирает претензии к публикации OpenAI и отмечает спорные моменты общения с исследователями.
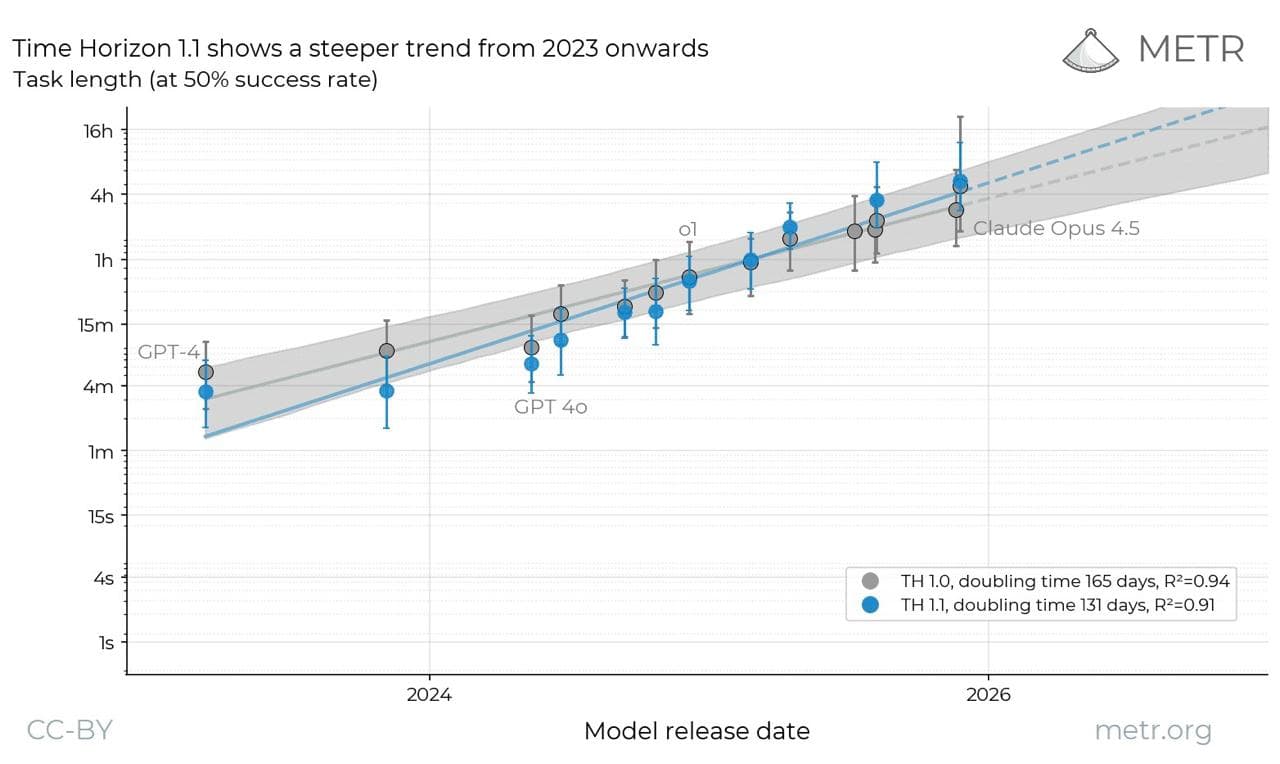
Горизонт METR оценивает сложность задачи в человеческих часах, а не время автономной работы модели.
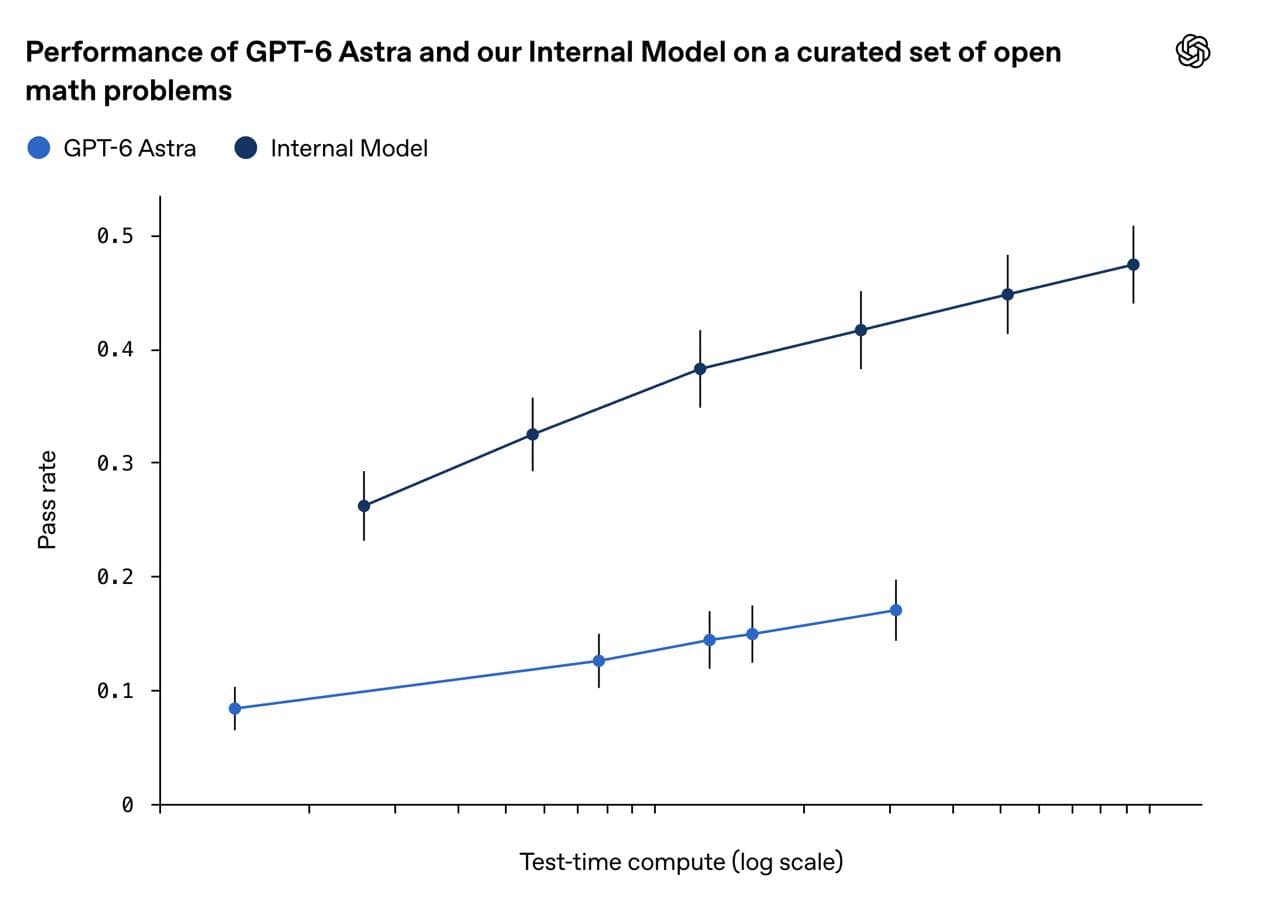
Размышление о том, как вычислительные ресурсы могут дать ИИ преимущество в решении сложных задач и усилить технологическое неравенство.
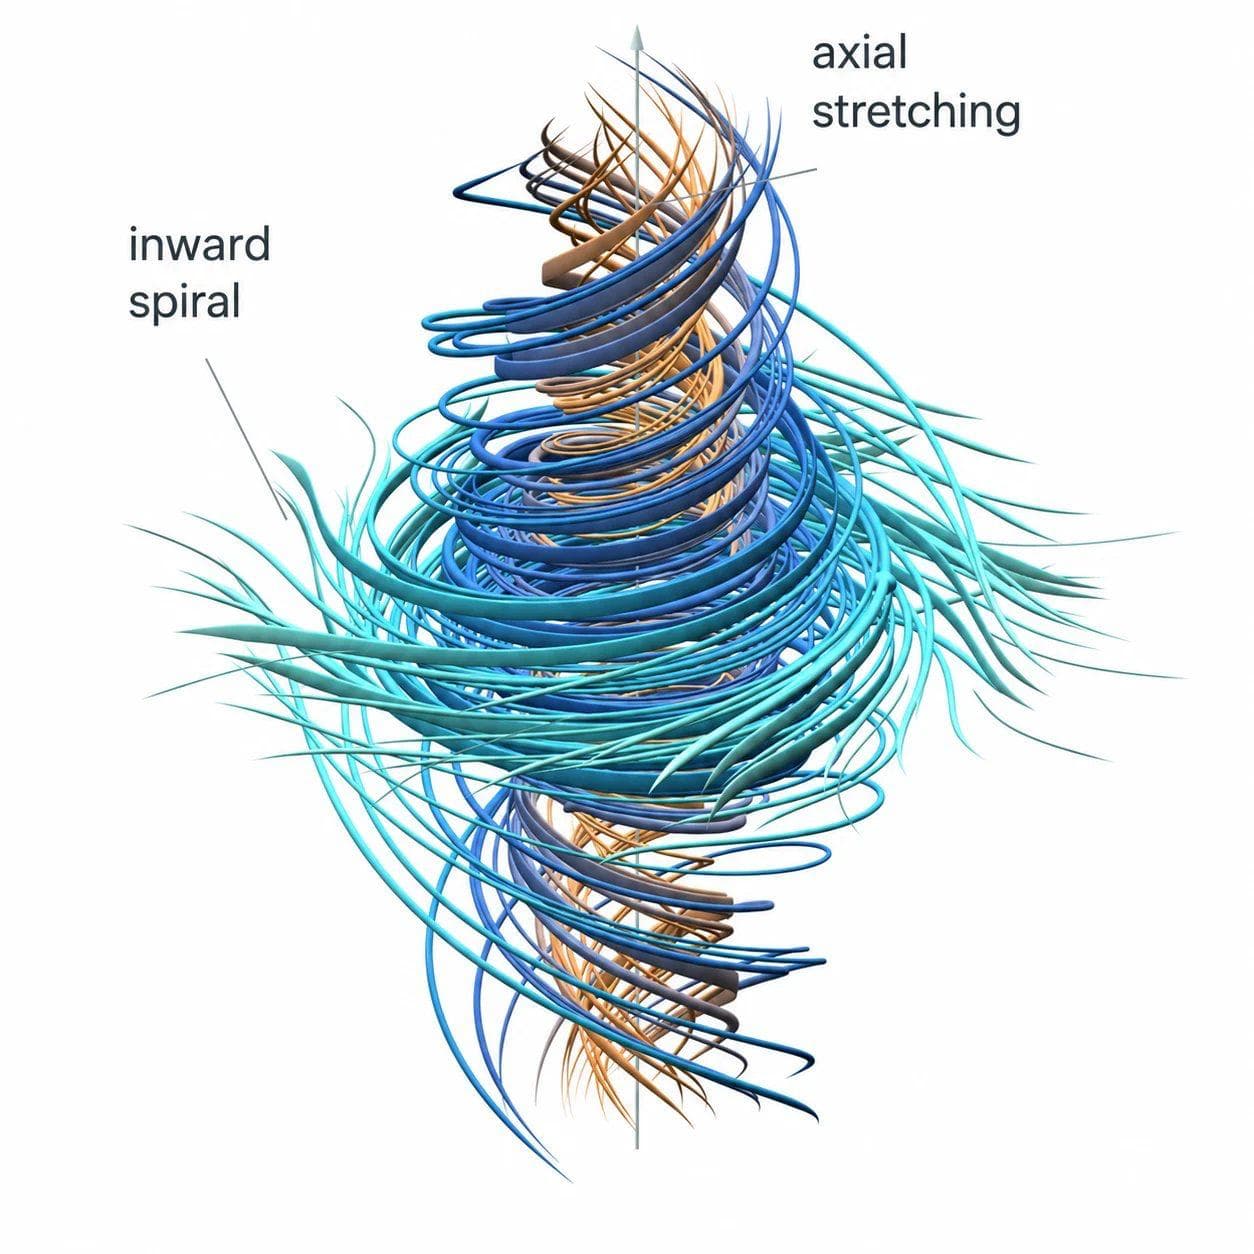
Короткое введение в уравнения Навье-Стокса и задачу тысячелетия, связанную с существованием гладких решений.
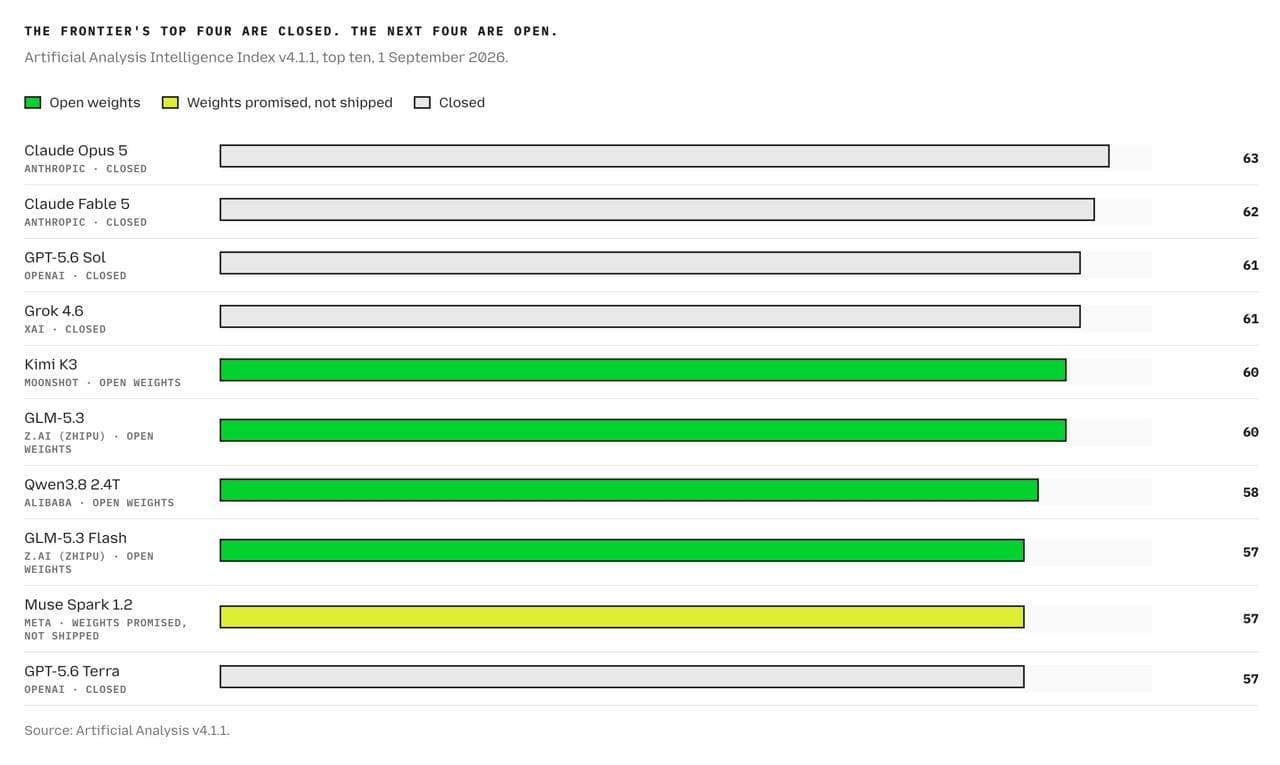
Отчёт Mozilla показывает, что лучшая открытая модель отстаёт от лучшей закрытой всего на 3 пункта индекса способностей.
Два исследования по-разному связывают использование ИИ с критическим мышлением — всё зависит от того, как определять зависимость и ИИ-грамотность.

Почему рост числа самостоятельных истцов в судах США может быть связан с ИИ и что это меняет для простых споров.

Как люди перенимают сильные ходы у моделей и почему перенос навыков лучше работает там, где есть быстрая проверка результата.
Как Codex Goal mode задаёт агенту цель, критерии готовности и длинный цикл попыток для сложных задач.

Как факт-бенчмарк даёт нижнюю оценку параметров закрытых LLM и почему эрудиция хуже сжимается дистилляцией.

Почему результат GPT-5.2 в задаче о глюонных амплитудах стал важным сигналом для науки и работы с ИИ.
AI-модели уже затронули десятки задач Эрдоша: от автономных решений до улучшения частичных результатов и формализации доказательств.

Epoch.AI перешёл от FrontierMath Tier 4 к нерешённым задачам, где успех модели станет реальным научным вкладом.

GPT-5.2 Pro решил 14 из 48 задач FrontierMath Tier 4, приблизившись к уровню, где модели могут вносить вклад в исследования.

Модель C2S-Scale помогла предложить комбинацию известных препаратов, усилившую иммунный ответ в тесте.
Folding@home объединяет добровольные компьютеры в сеть для моделирования белков, вирусов и лекарственных молекул.
LLM уже помогают химикам и биологам, а следующими кандидатами на ускорение исследований могут стать астрономия, математика и программирование.

Проект RakeSearch использует домашние ПК для комбинаторных задач и уже получил несколько рекордных результатов.
Эксперимент Anthropic с автономным вендингом показал, какие инструменты и обучение ещё нужны агентам для управления бизнесом.
Наблюдение о том, как ручные тексты принимают за GPT-генерацию, а ИИ всё увереннее проходит тест Тьюринга.
Как выбирать между Perplexity и Deep Research от OpenAI для быстрых и глубоких исследований.

Практический способ извлечь из интервью и подкастов инсайты о продукте, маркетинге и онбординге с помощью транскриптов и ChatGPT.
Практическое сравнение Deep Research в ChatGPT, Grok, Perplexity и DeepSeek на вопросе о постоянной нагрузке MacBook Pro.

Пример Deep Research в GPT: модель за девять минут проанализировала 21 источник по юридическому регулированию приложения.

Наблюдение о применении LLM в математике и наглядном представлении четырёхмерного пространства.
Отрицательный результат стартапа тоже ценен, если подробно зафиксировать процесс и выводы.
Поиск и все материалы раздела — в общей ленте.
КОНТАКТЫ
Напишите через форму на сайте или напрямую в Telegram. Быстро поймём, где ИИ может дать эффект, какой формат подойдёт руководителю или команде и с чего начать.
Менторская консультация
60 000 ₽