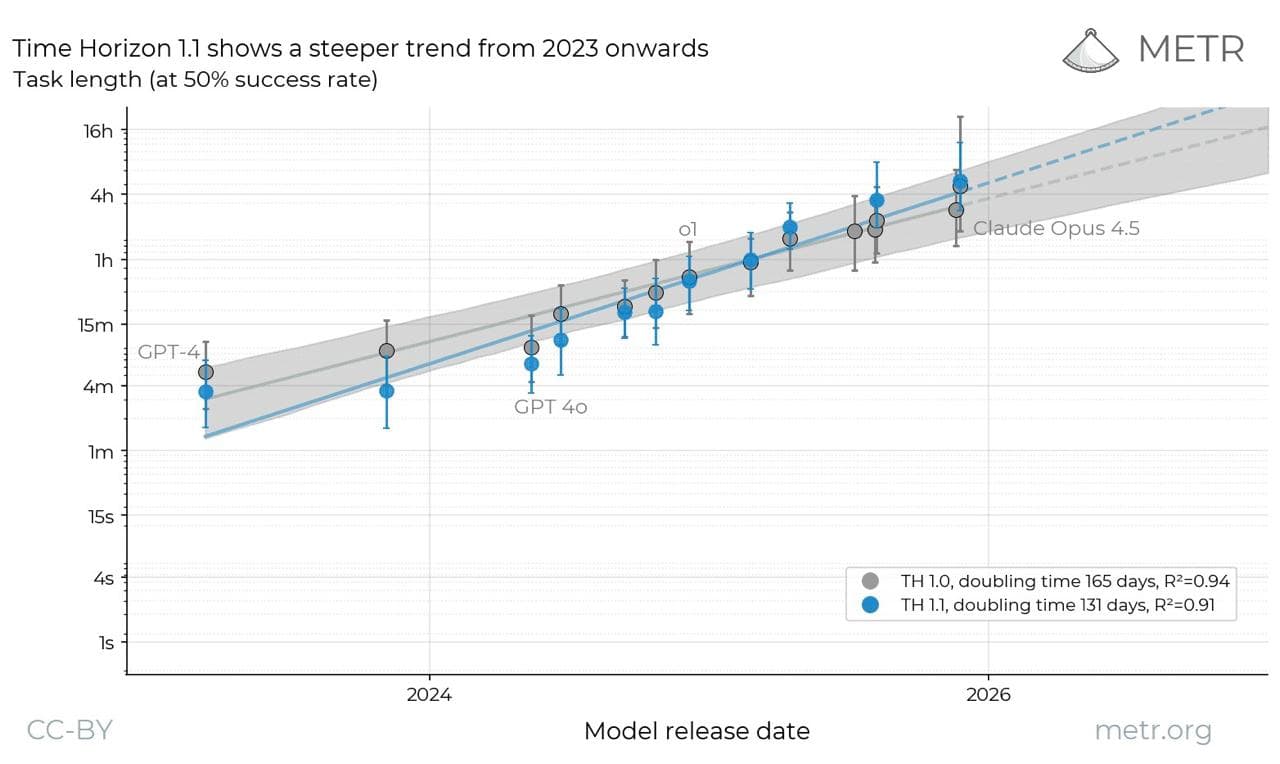
Что на самом деле измеряет бенчмарк METR: 17,4 часа — это часы человека, а не модели
Почти во всех статьях этот бенчмарк подают как «сколько часов модель может работать самостоятельно». METR в своём FAQ отвечает на этот вопрос прямо: нет. Горизонт — это мера сложности задачи, а не время, которое тратит модель. На задачах, которые агенты доводят до конца, они обычно в несколько раз быстрее человека.
Меряют так: берут задачу, на которую у эксперта-человека уходит N часов, и смотрят, доводит ли её модель до конца хотя бы в половине попыток. Это и есть N-часовой горизонт модели.
Рекорд сейчас у довольно старой закрытой модели Anthropic Claude Mythos Preview: 17,4 часа, задача на два рабочих дня специалиста. Более свежие модели ещё не тестировали. Сколько времени на неё потратила сама модель, METR не публикует: это зависит от провайдера инференса и обвязки.
В рейтинг METR модель добавили в мае. METR сами предупреждают: выше 16 часов их результаты ненадёжны, длинных задач с реальным человеческим замером в наборе мало. Рекорд уже чуть выше этой границы, а горизонт растёт быстрее: раньше удвоение занимало семь месяцев, теперь три-четыре.
Поэтому в текущем виде бенчмарк сейчас не актуален.