Как ИИ пишет весь код и самостоятельно закрывает задачи
Опыт команды, в которой ИИ пишет код и самостоятельно выполняет большинство задач, а человек проверяет результат.
Материалов по теме: 74
Опыт команды, в которой ИИ пишет код и самостоятельно выполняет большинство задач, а человек проверяет результат.
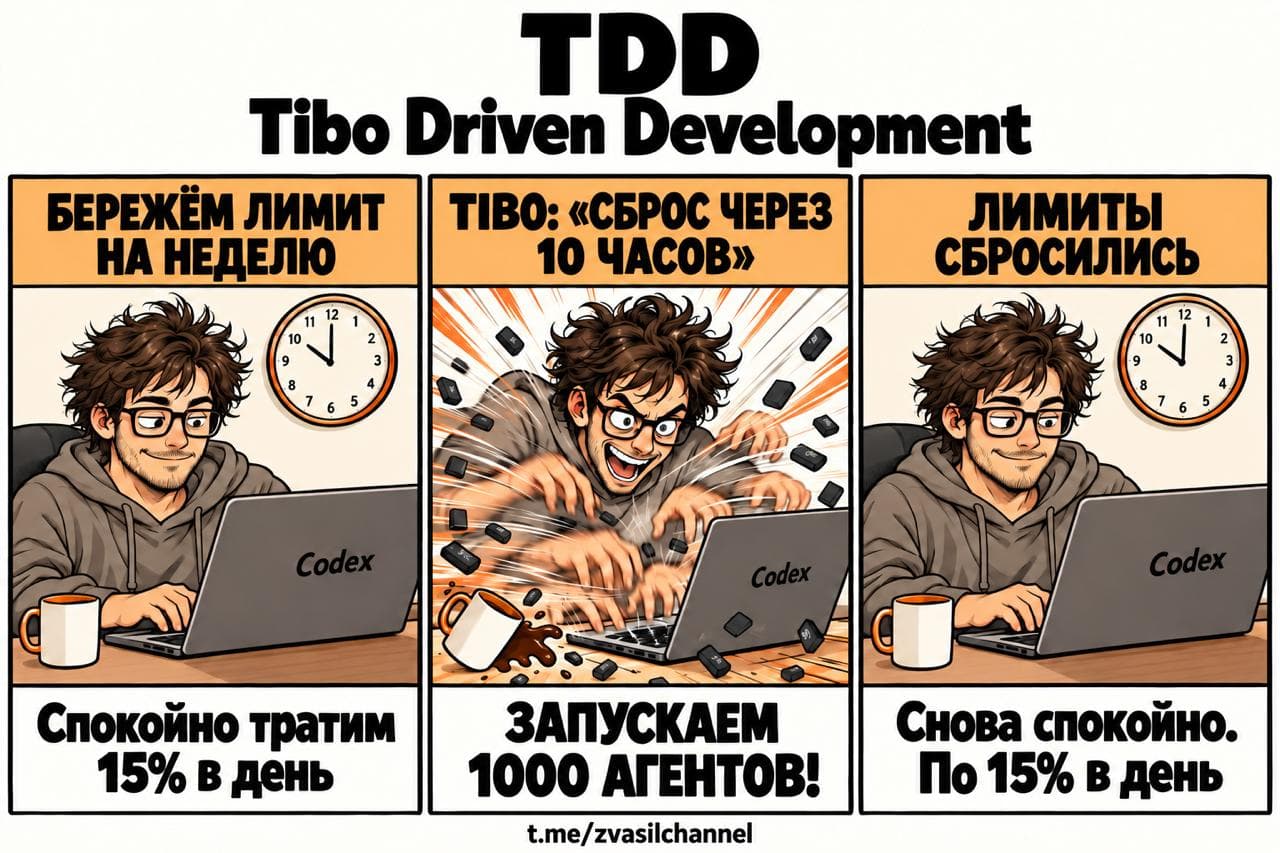
Плановый сброс лимитов позволяет копить тяжёлые задачи и запускать их, когда у агента снова доступны ресурсы.
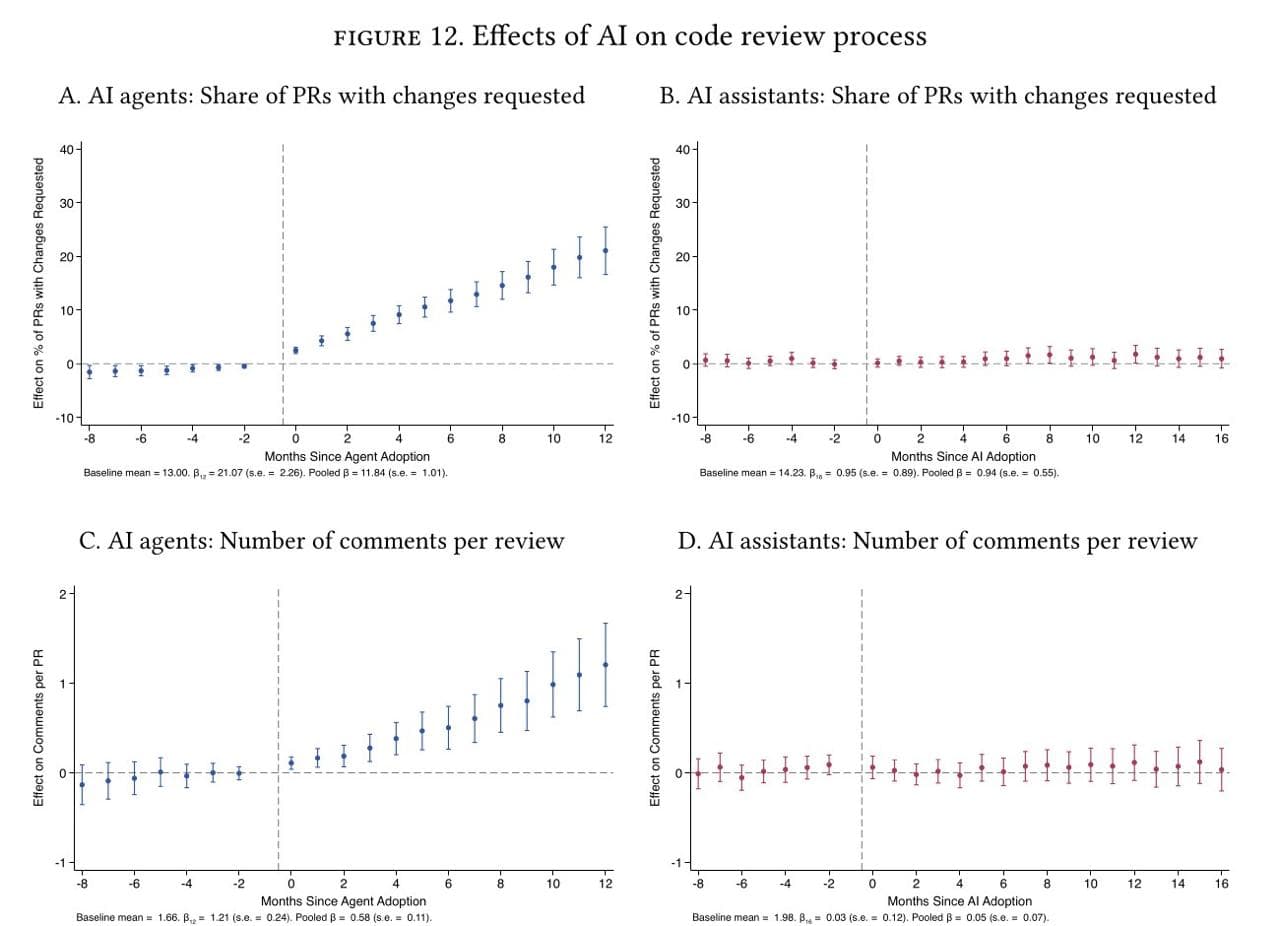
Исследование 718 компаний показывает: ИИ-агенты увеличивают объём кода и нагрузку на ревью, но не ускоряют закрытие задач.
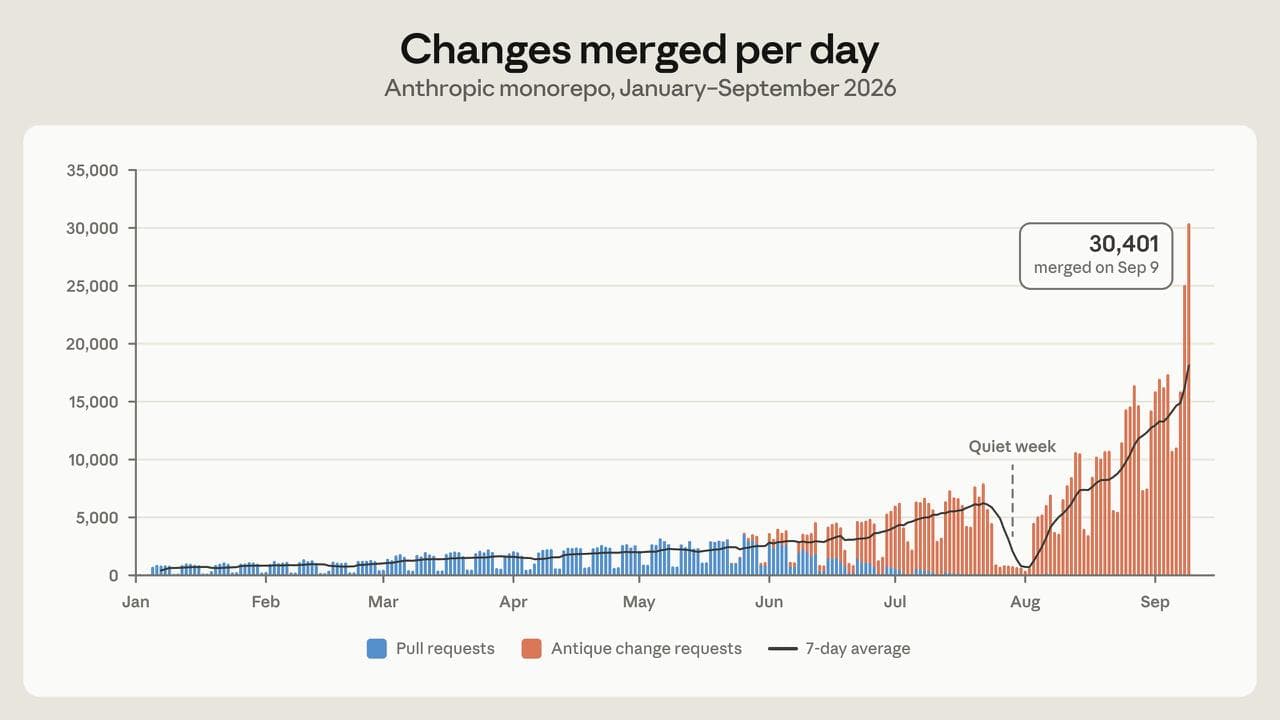
Рост до 30 тысяч изменений в день сделал Git узким местом инфраструктуры Anthropic, и компания разработала серверную систему Scion.
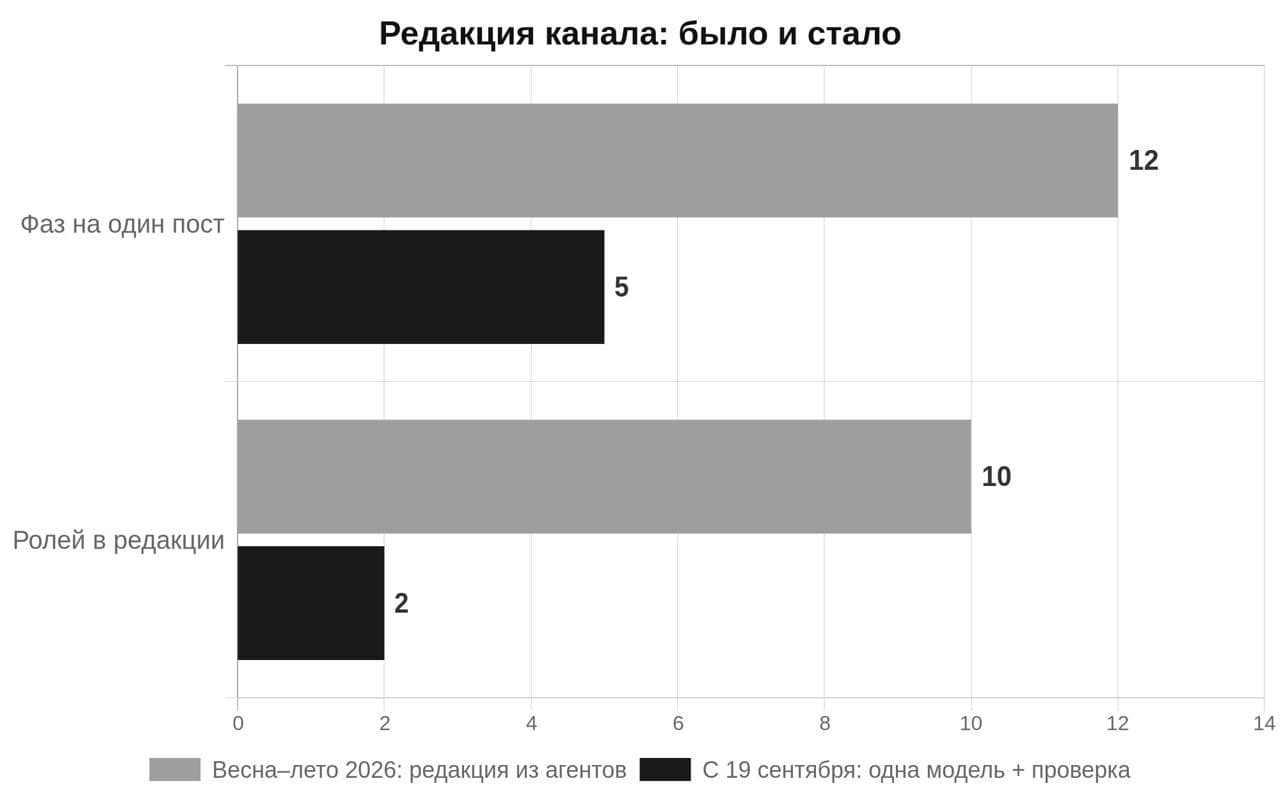
Автор объясняет, как сократил многофазную AI-редакцию до одного автора и независимой проверки фактов.
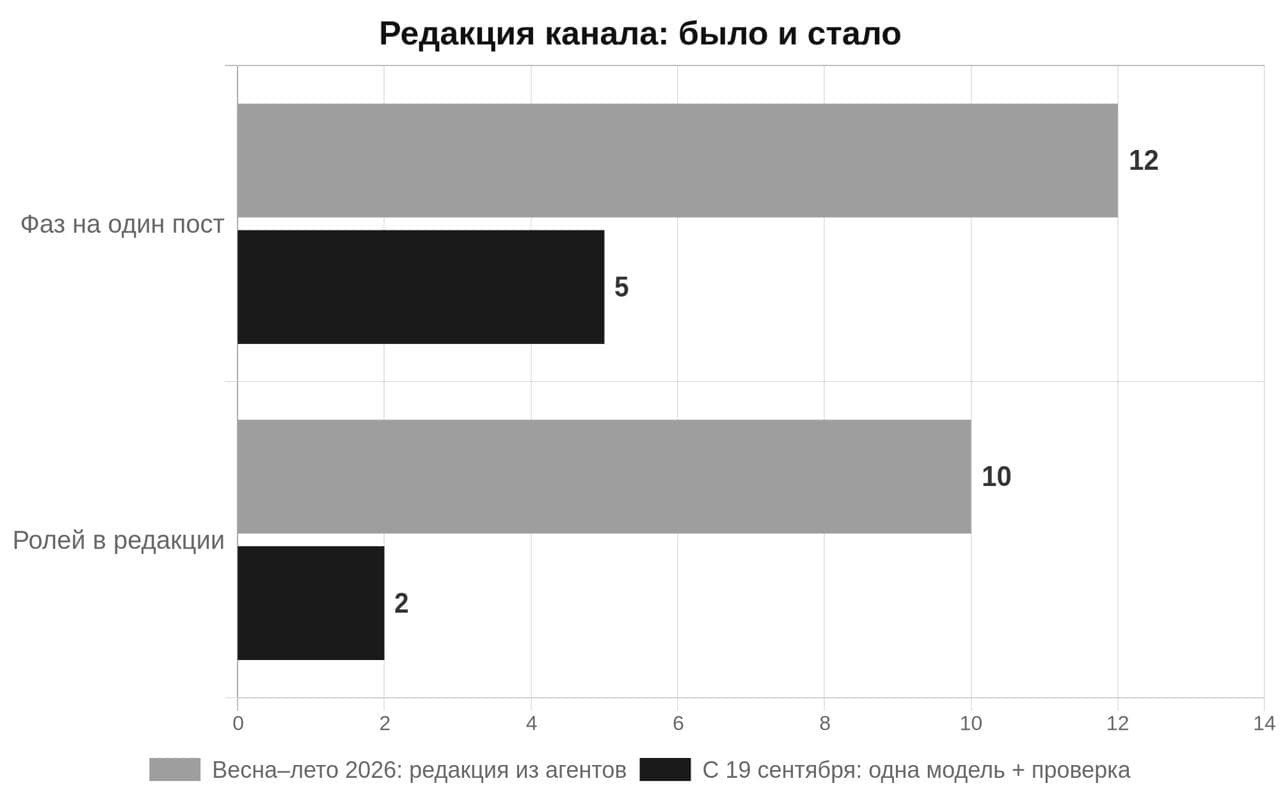
Автор рассказывает, почему редакционный процесс из 12 фаз и до 14 сессий заменили одной моделью и отдельной проверкой фактов.
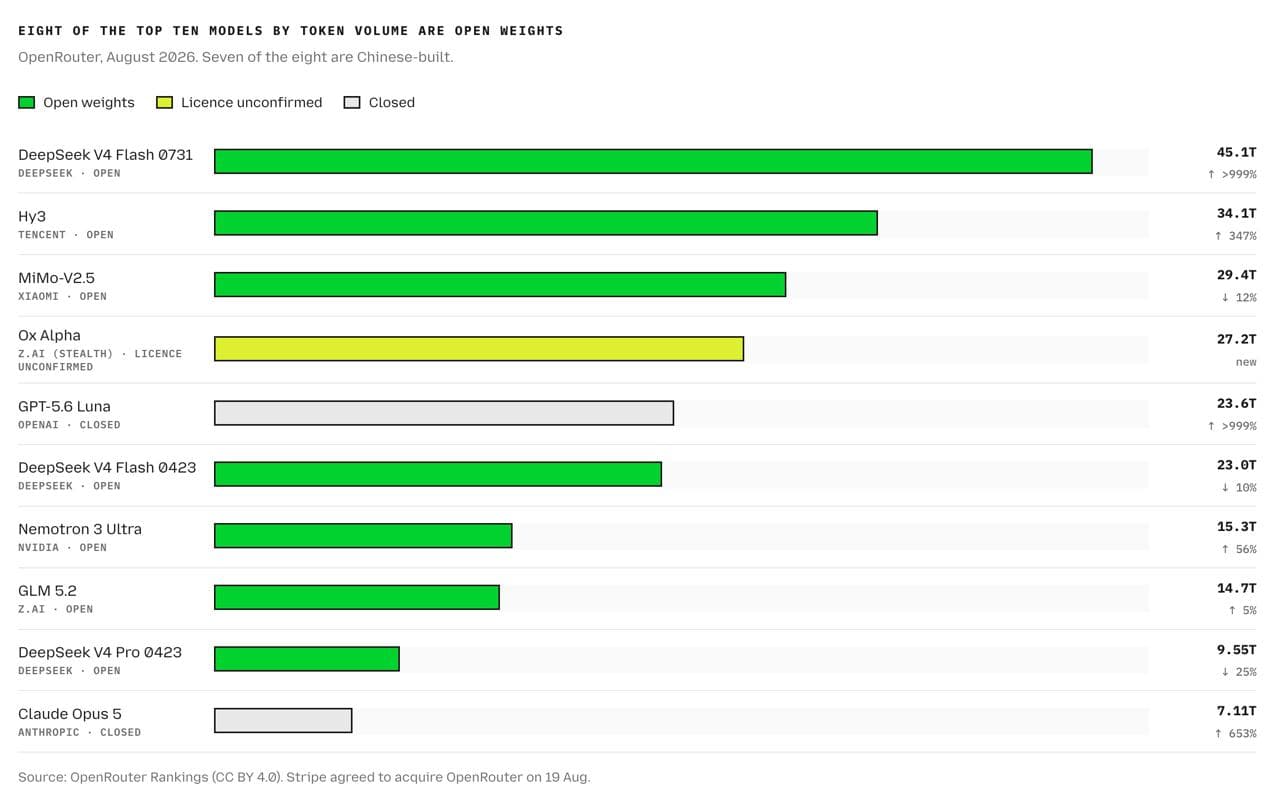
Автор разбирает популярность открытых моделей на OpenRouter и возможную роль цены, инвестиций в исследования и задержек.
AI-driven development делает экономически оправданными мелкие задачи и кастомные решения.
Вайб-кодинг нужен для быстрых прототипов, а агентная разработка строится вокруг архитектуры, тестов и проверок.

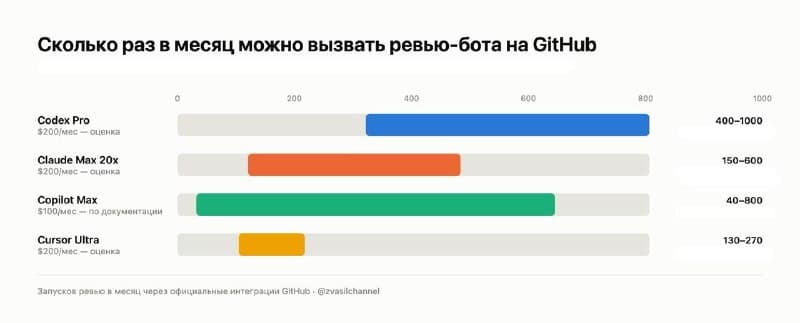
Личный расчёт показывает, почему Codex и Copilot выгоднее для проверки pull request.
Разбор CodeAlive-AI: сильным кодинг-моделям полезнее давать только отсутствующий контекст.
Claude Code переходит к риск-ориентированным подтверждениям, чтобы не превращать работу с агентом в бесконечные клики «Разрешить».
Личный разбор Cursor: модели Grok, инфраструктура и доступность инструмента для российских пользователей.
Cursor запустил Origin — платформу для хранения кода, pull request и работы ИИ-агентов, которая синхронизируется с GitHub.

Grok 4.6 сочетает качество фронтирных моделей, высокую скорость и низкую цену, поэтому подходит как быстрый ревьюер в Cursor CLI.

ИИ-инструменты меняют программирование: код всё чаще рождается из обычного текста в Markdown-файлах.

Запрос на рефакторинг имеет смысл только вместе с конкретным планом изменений, а не как выражение тревожности или перфекционизма.

Релизы Grok 4.5 и GPT 5.6, а также снятие лимитов Claude Code показывают, насколько быстро обостряется конкуренция AI-инструментов.

Как Code Inbox и Risk Profiles помогают Uber удерживать поток AI-сгенерированных PR в пределах пропускной способности ревью.

Разбор UX-особенности Codex: один и тот же .md файл может открываться как preview или как сырой markdown в зависимости от сценария.

Как выстроить GitHub-процесс, где Codex, Copilot, Cursor Bugbot и Claude Code Review проверяют работу друг друга.

Почему атомарная история изменений и ADR помогают Codex, Claude Code и Cursor работать в одном проекте без лишних конфликтов.

Что значит высокий результат GLM-5.2 в Code Arena и почему китайские Fable-like модели могут быстро прийти в open source.

Почему несколько коротких задач в очереди Codex часто дают результат лучше, чем один большой промпт.
Первый большой замер показывает рост генерации кода с AI, но ревью, тестирование и инциденты становятся новым узким местом.

Почему подписки на ИИ кажутся очень выгодными по сравнению с API и где может быть экономика таких тарифов.

Почему перерасход бюджета на Claude Code в Uber может быть не проблемой инструмента, а следствием новой производительности.

Почему для кода важна не только модель, но и связка инструмента, режима размышлений и подготовки под конкретную модель.

Как Fast и Standard режимы Cursor Composer 2.5 меняют экономику фоновых задач и почему скорость не всегда важнее цены.

Почему агентные инструменты из разных классов постепенно приходят к похожей структуре: сессии, чат, справочная панель, диффы и approvals.

Поиск и все материалы раздела — в общей ленте.
КОНТАКТЫ
Напишите через форму на сайте или напрямую в Telegram. Быстро поймём, где ИИ может дать эффект, какой формат подойдёт руководителю или команде и с чего начать.
Менторская консультация
60 000 ₽